Руководство
Как выбрать LLM API для продукта и не пожалеть
Практическая методика выбора LLM API: от качества и задержки до совместимости, бюджета, отказоустойчивости и безопасной смены модели.
31 августа 2026 г.5 мин
Читать статью 
Разборы моделей, API-интеграций, web-данных и экономики запросов.
Практическая методика выбора LLM API: от качества и задержки до совместимости, бюджета, отказоустойчивости и безопасной смены модели.
Практическое руководство по Agent API: постановка задачи, Idempotency-Key, входные строки, JSON Schema, SSE-события, бюджет, отмена и проверка источников.
Пошаговая работа с базой знаний через API: создание, идемпотентная загрузка файлов, статус индексации, семантический поиск, ответы и цитаты.
Практическое подключение Remote MCP к AI-агенту: адрес сервера, API-ключ или OAuth, минимальные scopes, проверка tools и безопасная эксплуатация.
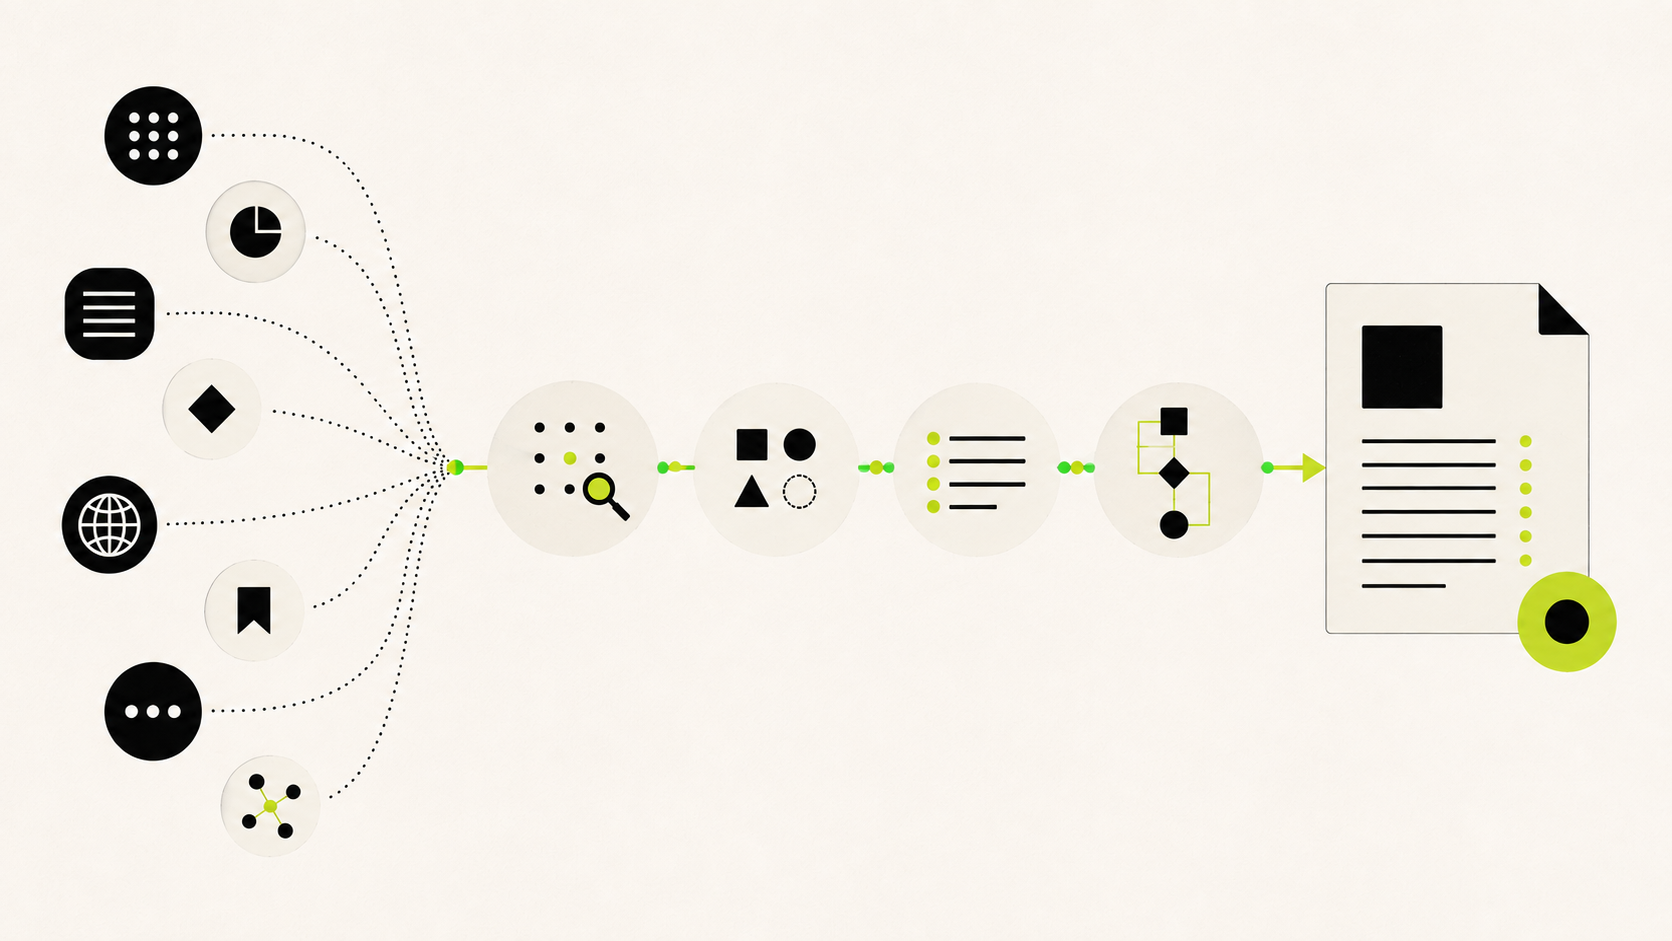
Как использовать Research API для веб-исследований: поставить задачу, ограничить бюджет, отслеживать асинхронный запуск и проверить цитаты.
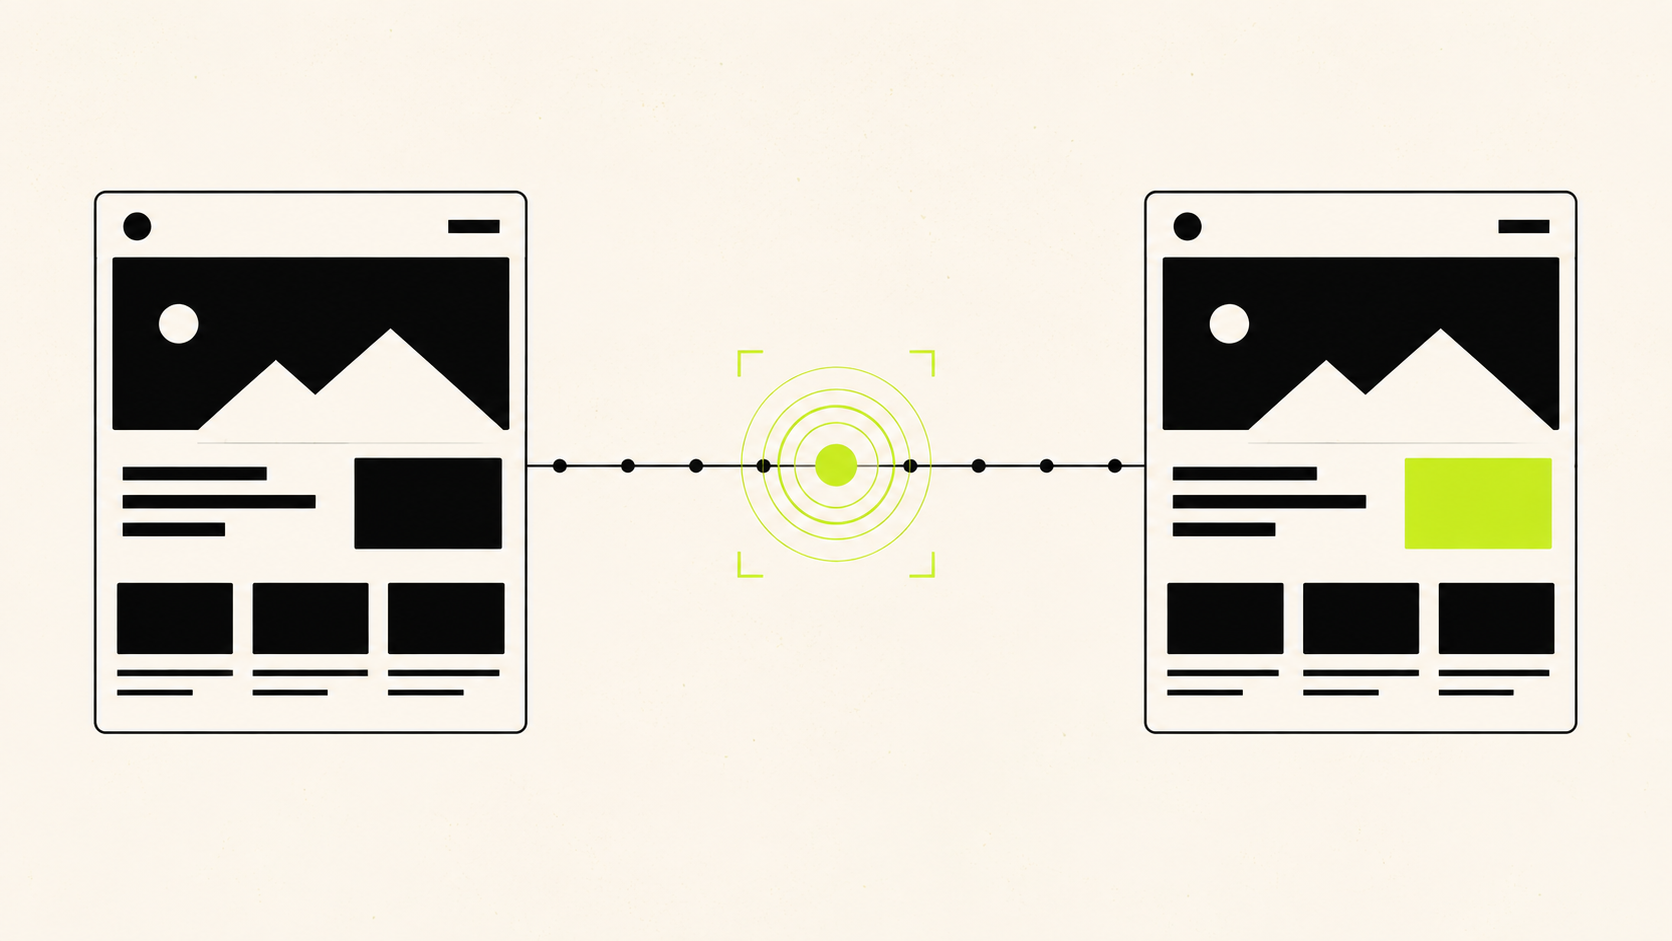
Как настроить мониторинг изменений сайта через API: выбрать устойчивую область, создать монитор, читать историю и получать события через webhook.
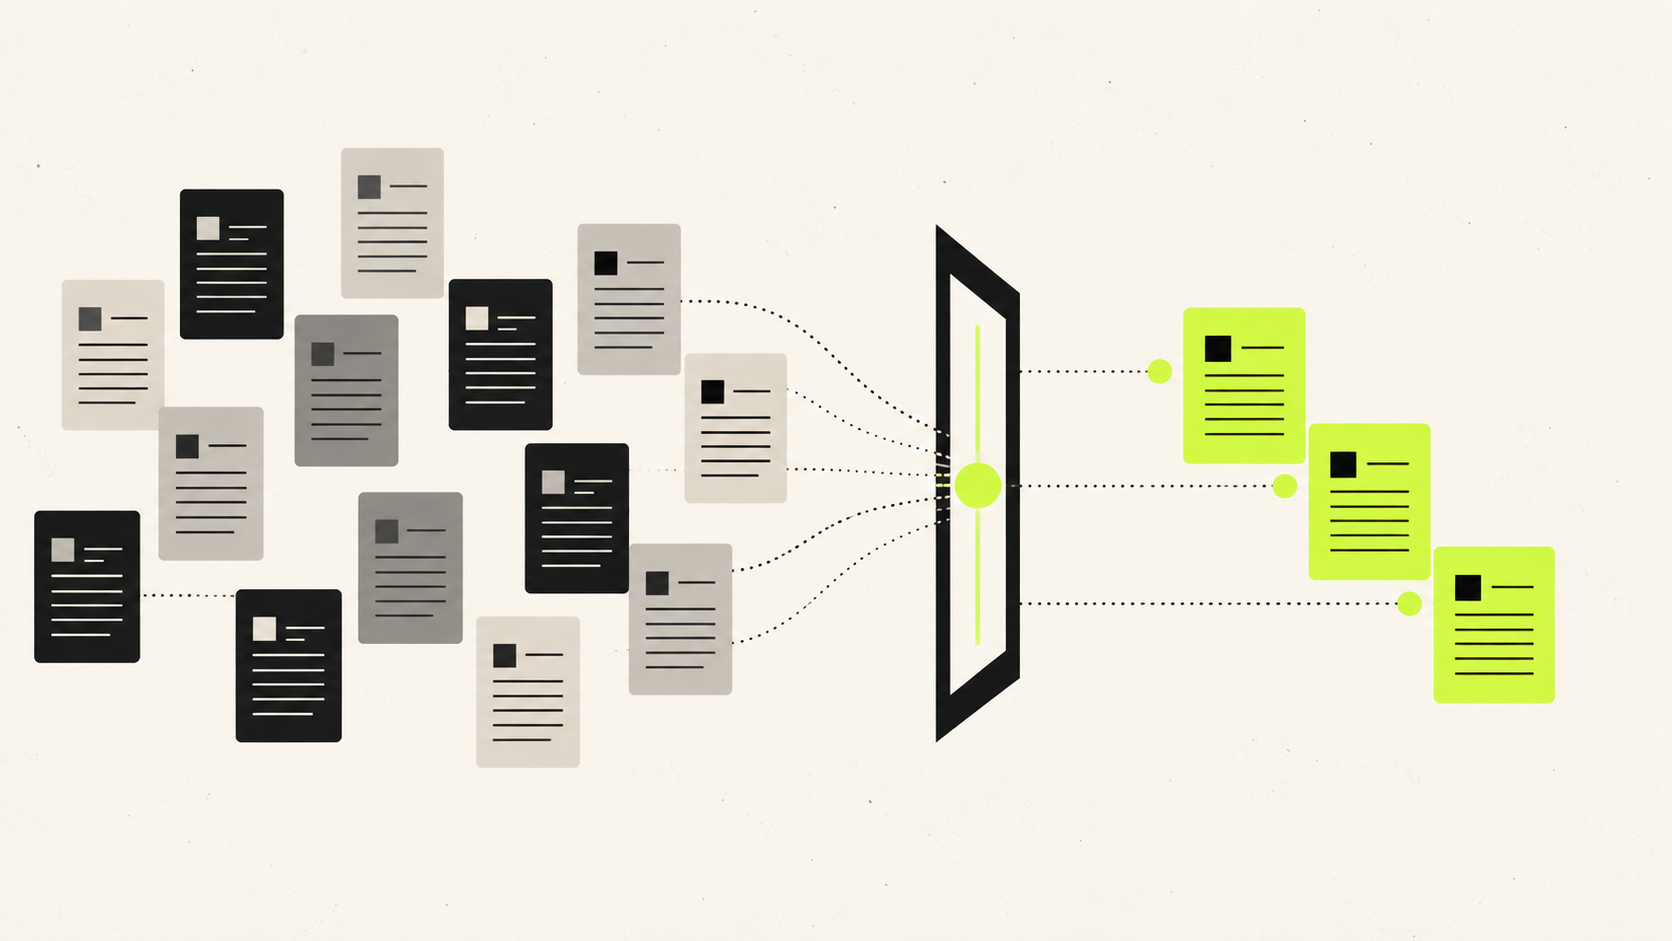
Практическое руководство по Rerank API для RAG: отбор кандидатов, формат документов, topN, сбор контекста и измерение качества retrieval.
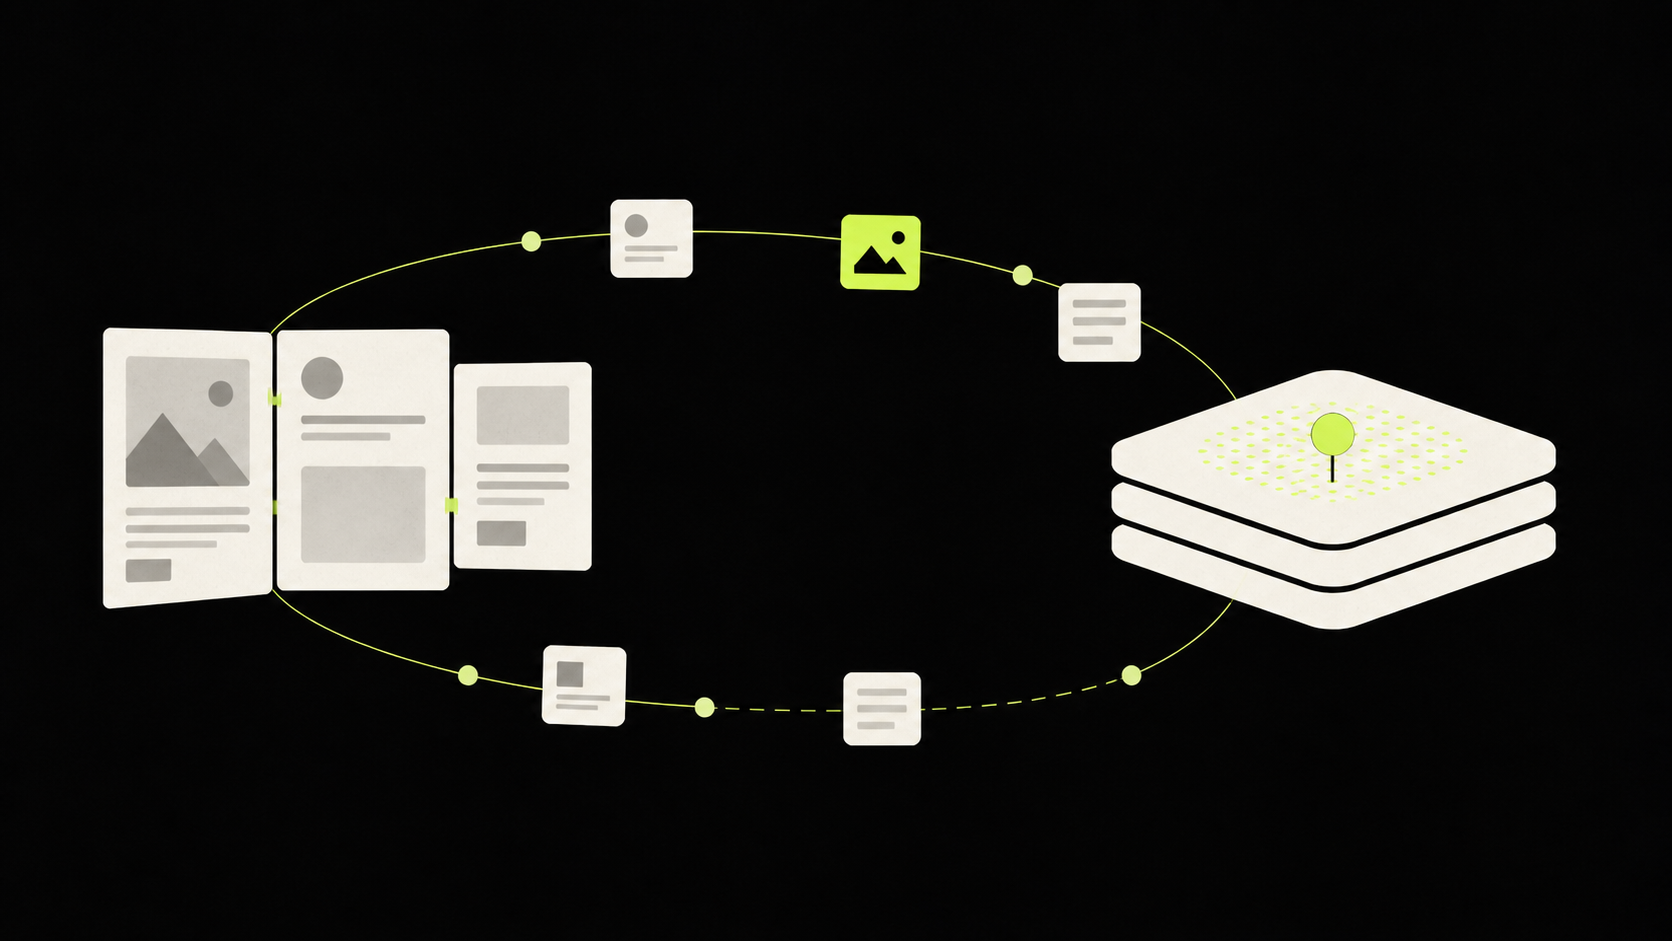
Как автоматически обновлять базу знаний из сайта: ограничить обход, обнаруживать изменения, безопасно индексировать новую версию и проверять свежесть.
Как превратить вопрос и веб-источники в проверяемый JSON: составить схему, ограничить бюджет, обеспечить идемпотентность и проверить результат.
Практическое руководство по Contents API: пакетная загрузка страниц, отдельные статусы, кэш, highlights, ссылки и подготовка контента для AI.
Разбираем SSE streaming в LLM API: как читать поток через fetch, буферизовать события, показывать части ответа и обрабатывать отмену и ошибки.
Разбираем, как использовать Embeddings API для семантического поиска: подготовить фрагменты, построить векторный индекс и измерить качество retrieval.
Пошагово подключаем LLM API к n8n: настраиваем HTTP Request, безопасно передаём ключ, формируем JSON и обрабатываем ответы и ошибки.
Разбираем, как ограничить бюджет AI-агента через maxSpendKopecks, effort, число источников, scopes, идемпотентность и контроль фактической стоимости.
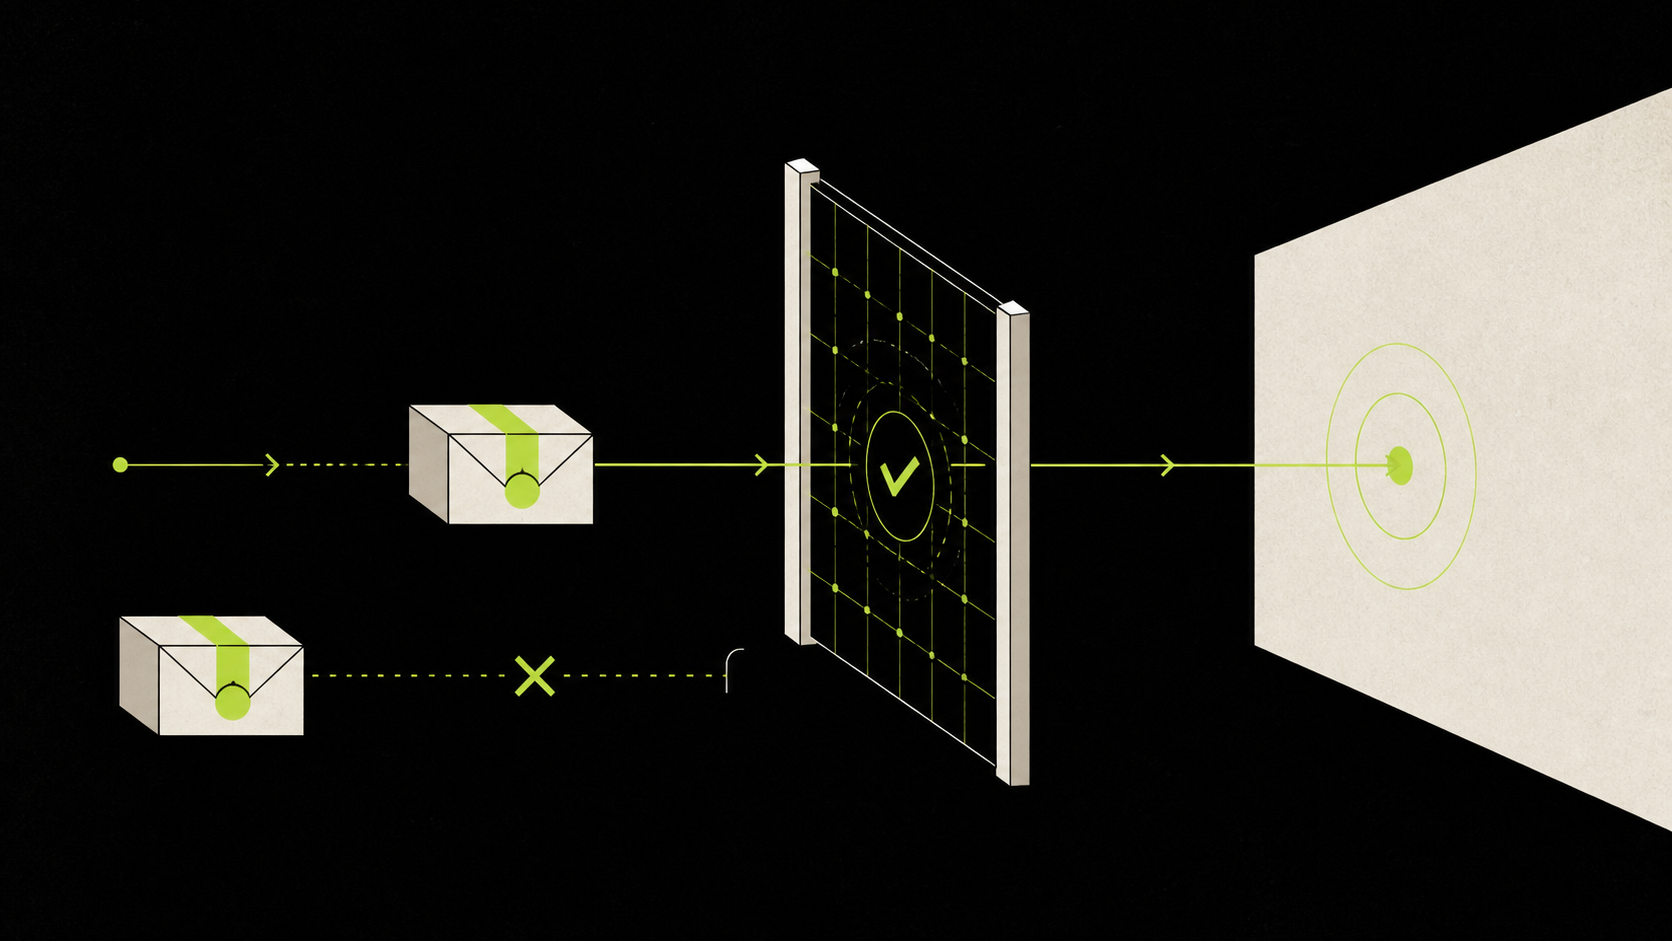
Практическая схема безопасного webhook для AI API: raw body, HMAC SHA-256, timestamp, защита от повторов, очередь и ротация секрета.
Пошагово подключаем OpenAI SDK к LLMTOKENAPI: меняем base URL, выбираем модель, защищаем ключ и проверяем Responses API на сервере.
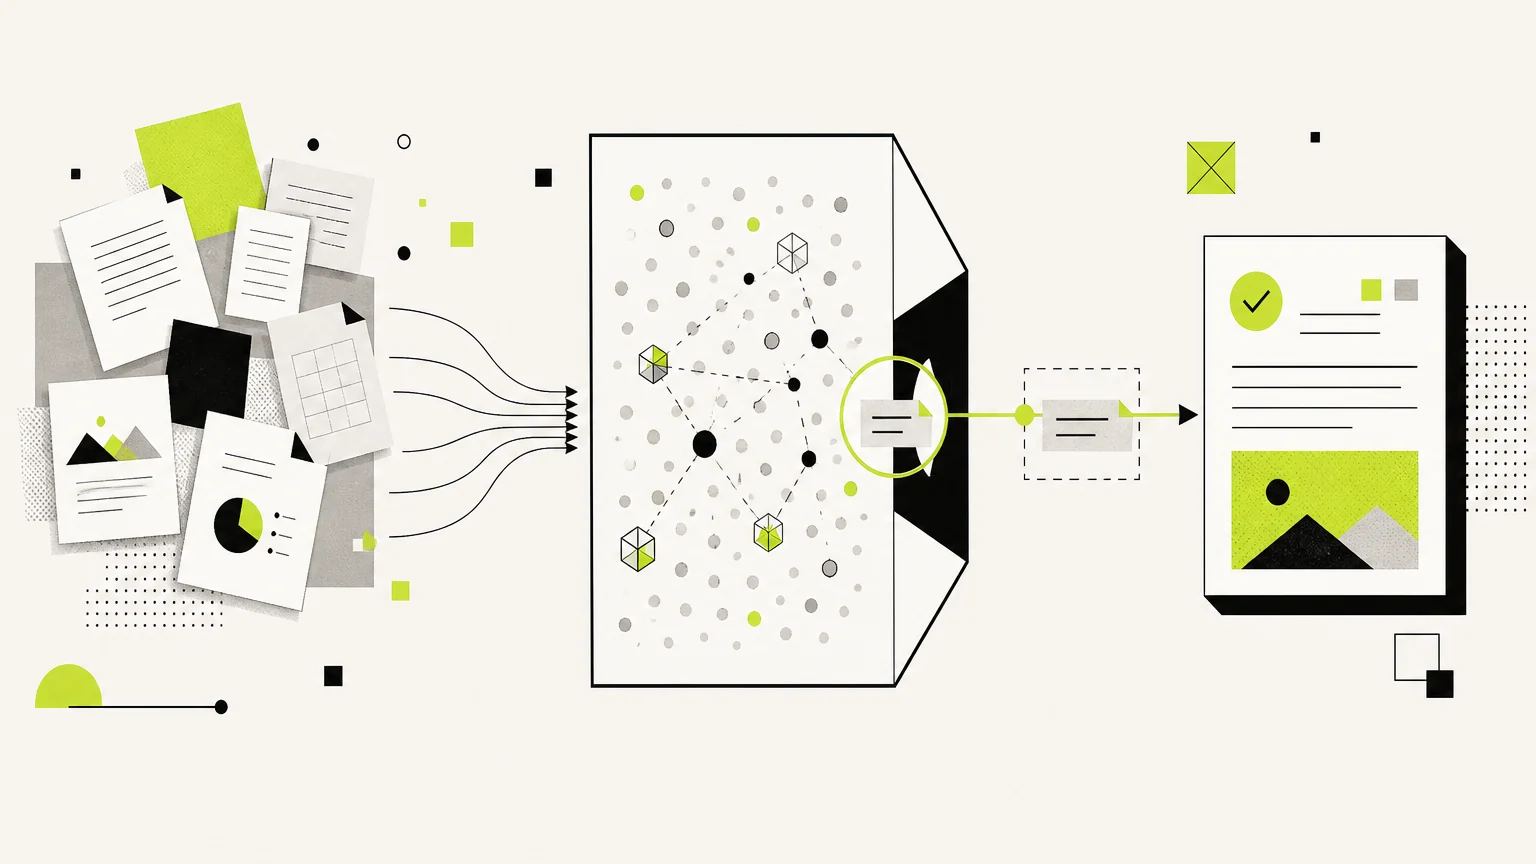
Как построить RAG по внутренним документам: загрузка и очистка, разбиение на фрагменты, embeddings, retrieval, цитаты, права доступа и оценка качества.
Формулы и практические приёмы для расчёта стоимости LLM API: токены, повторные вызовы, инструменты, лимиты, резерв и стоимость успешной операции.
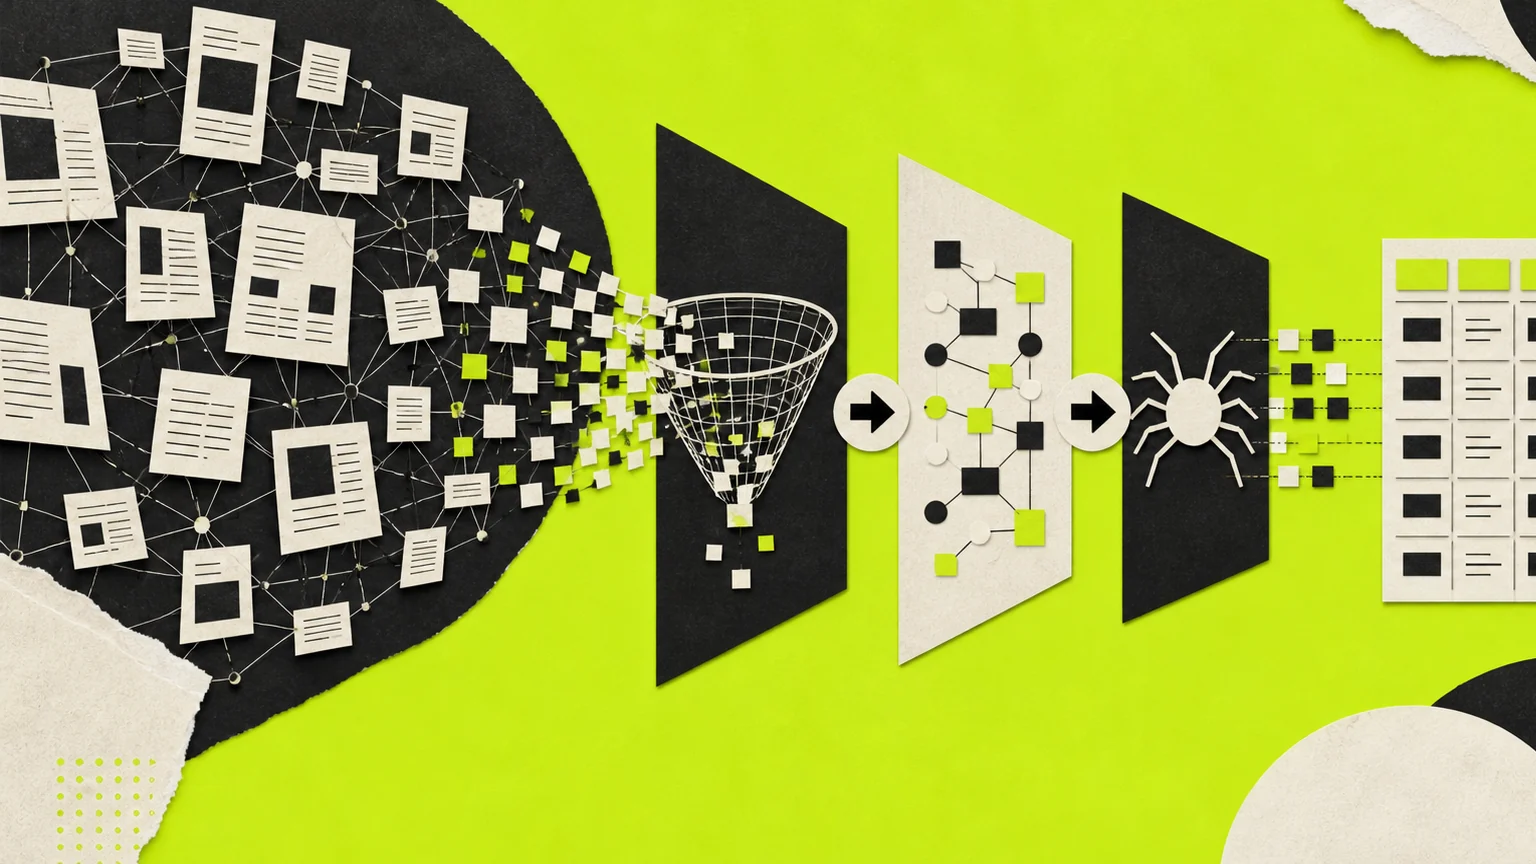
Разбираем производственный конвейер web scraping: выбор между scrape, map и crawl, очистка контента, идемпотентность, лимиты и контроль качества.
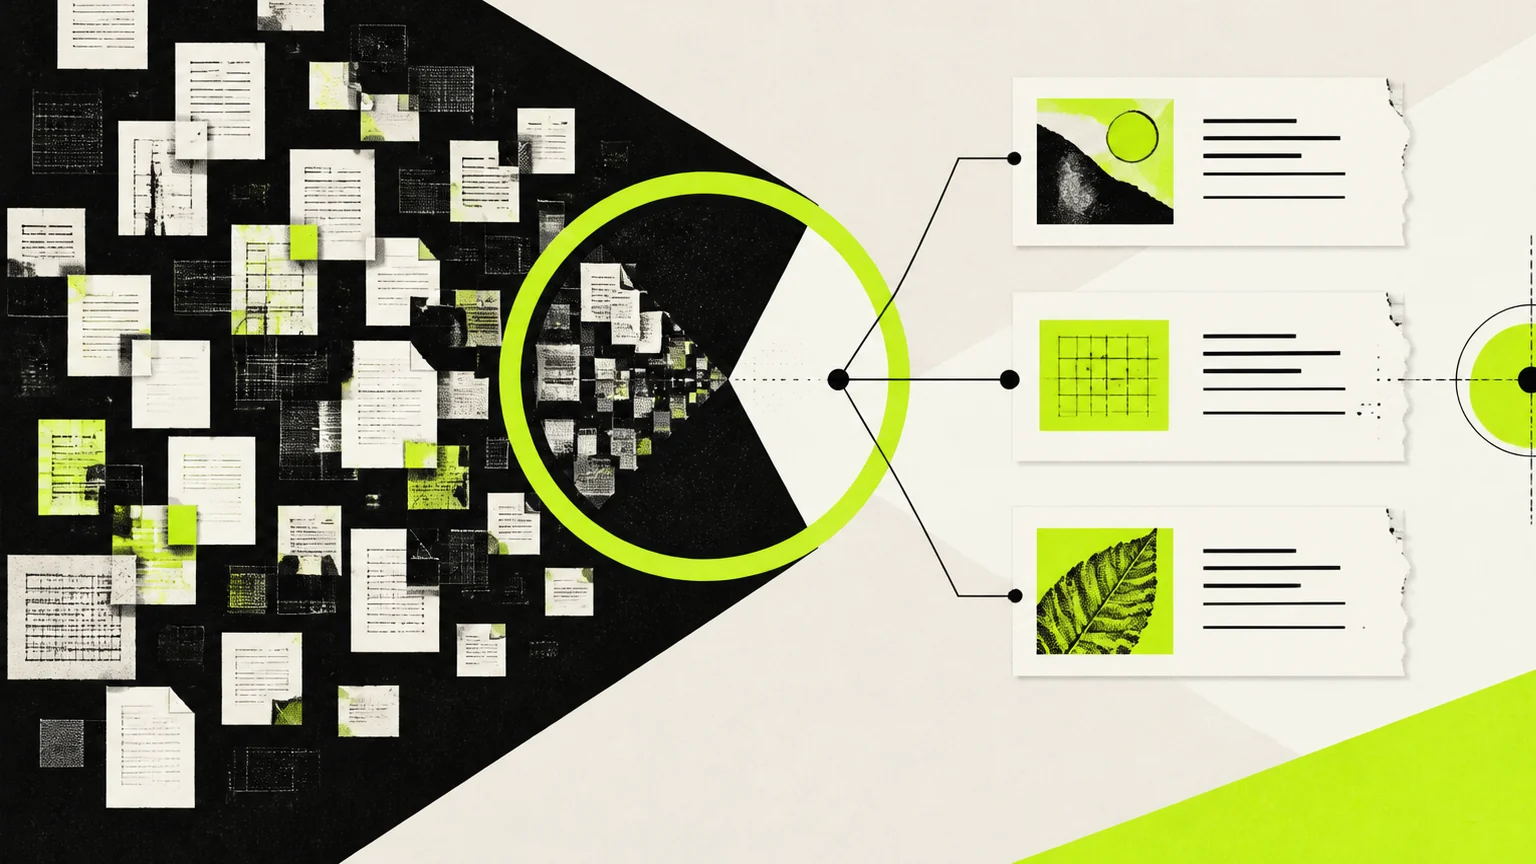
Как собрать AI-поиск, который находит свежие страницы, отбирает доказательства, формирует ответ с цитатами и честно сообщает о нехватке данных.
Сравниваем два протокола LLM API по структуре запроса, потоковой выдаче, инструментам и миграции без привязки продуктовой логики к одному формату.